Domain go-discover.de kaufen?
Wir ziehen mit dem Projekt
go-discover.de um.
Sind Sie am Kauf der Domain
go-discover.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain go-discover.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
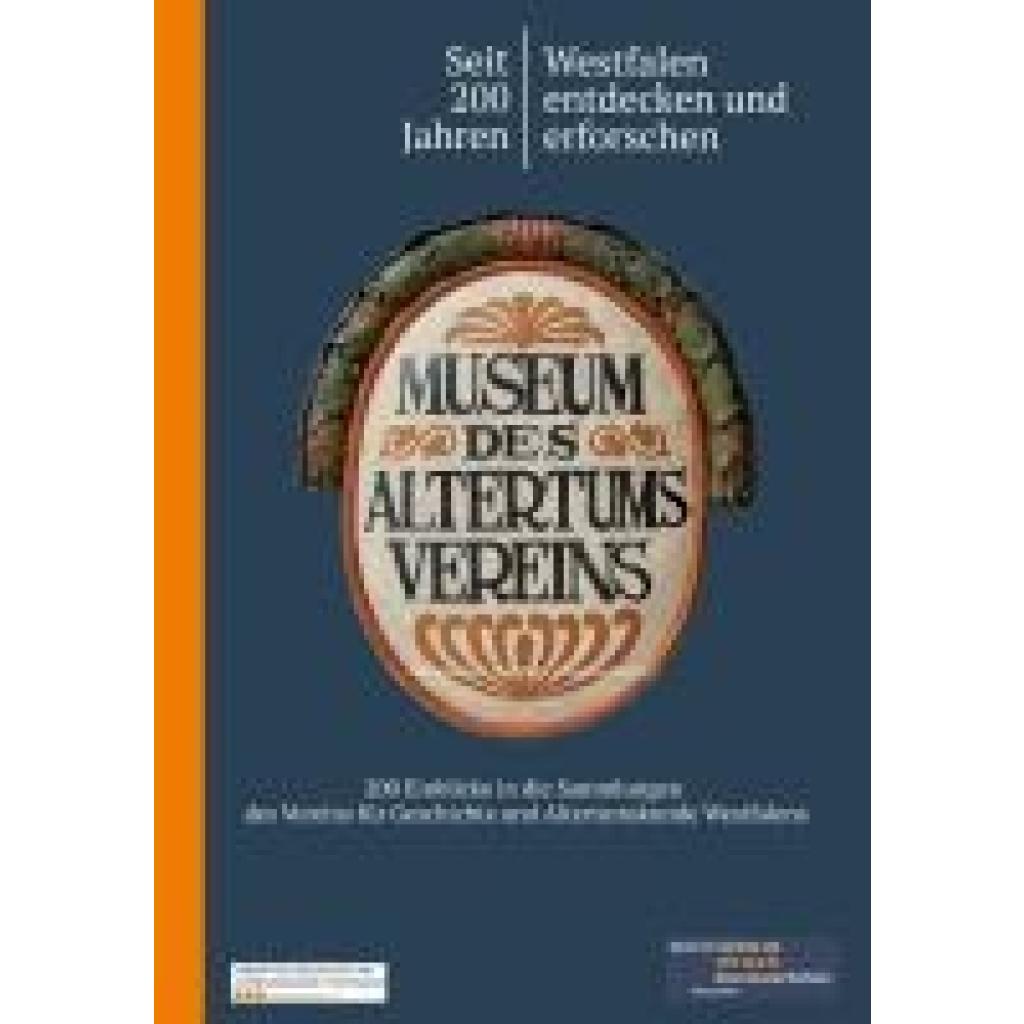
Verein für Geschichte und Altertumskunde Westfalens. Abteilung Münster e. V.: Seit 200 Jahren Westfalen entdecken und erforschenSeit 200 Jahren Westfalen entdecken und erforschen , Museum des Altertumsvereins. 200 Einblicke in die Sammlungen des Vereins für Geschichte und Altertumskunde Westfalens , Bypass- & Ablassventile > Luftversorgung , Erscheinungsjahr: 20250531, Autoren: Verein für Geschichte und Altertumskunde Westfalens. Abteilung Münster e. V., Redaktion: Dethlefs, Gerd~Neuwöhner, Andreas, Seitenzahl/Blattzahl: 492, Keyword: Kunstsammlungen Westfalen; Kunstgeschichte Westfalen; Archäologie Westfalen, Fachkategorie: Geschichte~Antiquitäten und Sammelobjekte, Warengruppe: HC/Kunst/Antiquitäten, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 285, Breite: 200, Höhe: 41, Gewicht: 2210, Produktform: Gebunden,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Begegnung - Erkundung - Erlebnis, Fachbücher von Martina E. BeckerInterkultureller Kontakt zeigt sich derzeit angesichts der vielfältigen globalen Entwicklungen als mannigfaltiger Diskussionsgegenstand. Auch die deutsch-polnischen Beziehungen unterlagen in den letzten Jahrzehnten unterschiedlichen Annäherungs- und Entfernungsstadien. Der Blick auf Lehrkräfte, die massgeblich für Austauschprojekte an Schulen dieser beiden Länder seit den 1970er Jahren verantwortlich sind, fehlte jedoch bisher in der volkskundlich-kulturanthropologischen Forschung. Hierzu führte die Autorin mit Lehrerinnen und Lehrern unterschiedlicher Schulen in Deutschland und Polen leitfragenorientierte Interviews über deren jeweiligen Erlebnis-, Erinnerungs- und Erfahrungsraum, die sowohl im Kontext gesamtgesellschaftlicher Transformationsprozesse einer realsozialistischen als auch postrealsozialistischen Ära zu sehen sind. Indem mit Hilfe der volkskundlich-kulturwissenschaftlichen Bewusstseinsanalyse in mikroperspektivischer Weise nach Strukturen von Austauschprozessen gefragt wird, treten in dieser Studie nicht nur das jeweilige Selbstverständnis sowie Kooperationsstrategien der befragten Pädagoginnen und Pädagogen, sondern auch sozialwirksame Hierarchiestrukturen, die einer kulturell geprägten Arbeitswelt im Bildungssektor unterliegen, zutage.44,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verein für Geschichte und Altertumskunde Westfalens. Abteilung Münster e. V.: Seit 200 Jahren Westfalen entdecken und erforschenSeit 200 Jahren Westfalen entdecken und erforschen , Museum des Altertumsvereins. 200 Einblicke in die Sammlungen des Vereins für Geschichte und Altertumskunde Westfalens , Bypass- & Ablassventile > Luftversorgung , Erscheinungsjahr: 20250531, Autoren: Verein für Geschichte und Altertumskunde Westfalens. Abteilung Münster e. V., Redaktion: Dethlefs, Gerd~Neuwöhner, Andreas, Seitenzahl/Blattzahl: 492, Keyword: Kunstsammlungen Westfalen; Kunstgeschichte Westfalen; Archäologie Westfalen, Fachkategorie: Geschichte~Antiquitäten und Sammelobjekte, Warengruppe: HC/Kunst/Antiquitäten, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 285, Breite: 200, Höhe: 41, Gewicht: 2210, Produktform: Gebunden,39,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Begegnung - Erkundung - Erlebnis, Fachbücher von Martina E. BeckerInterkultureller Kontakt zeigt sich derzeit angesichts der vielfältigen globalen Entwicklungen als mannigfaltiger Diskussionsgegenstand. Auch die deutsch-polnischen Beziehungen unterlagen in den letzten Jahrzehnten unterschiedlichen Annäherungs- und Entfernungsstadien. Der Blick auf Lehrkräfte, die massgeblich für Austauschprojekte an Schulen dieser beiden Länder seit den 1970er Jahren verantwortlich sind, fehlte jedoch bisher in der volkskundlich-kulturanthropologischen Forschung. Hierzu führte die Autorin mit Lehrerinnen und Lehrern unterschiedlicher Schulen in Deutschland und Polen leitfragenorientierte Interviews über deren jeweiligen Erlebnis-, Erinnerungs- und Erfahrungsraum, die sowohl im Kontext gesamtgesellschaftlicher Transformationsprozesse einer realsozialistischen als auch postrealsozialistischen Ära zu sehen sind. Indem mit Hilfe der volkskundlich-kulturwissenschaftlichen Bewusstseinsanalyse in mikroperspektivischer Weise nach Strukturen von Austauschprozessen gefragt wird, treten in dieser Studie nicht nur das jeweilige Selbstverständnis sowie Kooperationsstrategien der befragten Pädagoginnen und Pädagogen, sondern auch sozialwirksame Hierarchiestrukturen, die einer kulturell geprägten Arbeitswelt im Bildungssektor unterliegen, zutage.44,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.